LDA (Latent Dirichlet Allocation)
LDA (Latent Dirichlet Allocation: 잠재 디리클레 할당)
1. LDA의 정의 및 특징
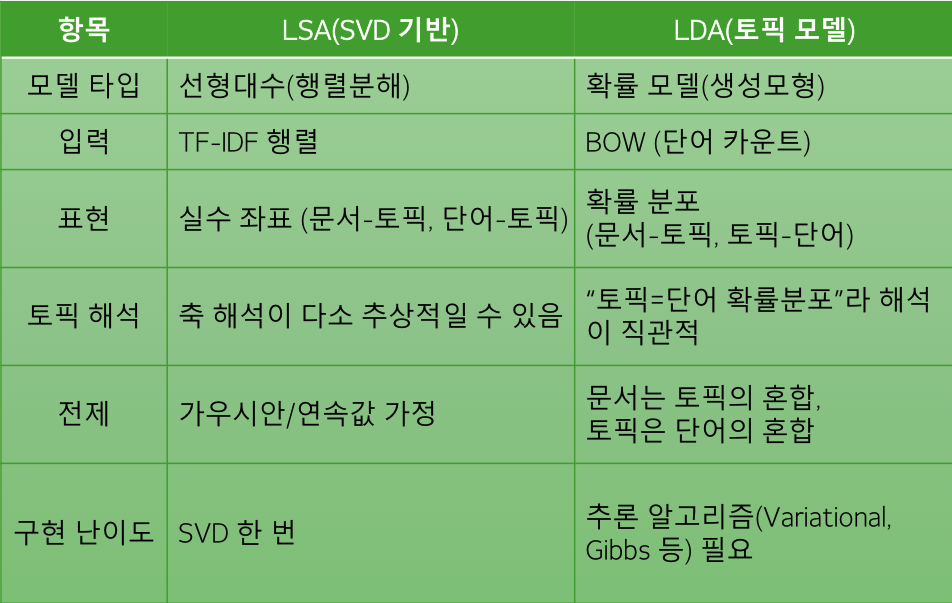
LDA는 토픽 모델링의 대표적인 알고리즘으로, 주어진 문서들에 대해 각 문서에 어떤 주제들이 존재하는지에 대한 확률 모델입니다.
핵심은 다음 두 가지 분포를 모두 추정하는 것입니다.
- 토픽별 단어의 분포
- 문서별 토픽의 분포
2. LDA의 가정
LDA는 문서를 구성하는 방식에 대해 다음과 같이 가정합니다.
- 문서 = 여러 토픽이 섞인 것
- 토픽 = 여러 단어가 섞인 것
3. 학습 과정
LDA의 학습은 문서 집합에서 토픽-단어 분포와 문서-토픽 분포를 역으로 추정하는 과정입니다. 즉, 이미 존재하는 문서와 그 안의 단어들을 보고 그 이면에 있는 토픽의 구조를 파악해 냅니다.
4. 토픽 모델링
문서의 집합에서 토픽을 찾아내는 프로세스를 토픽 모델링이라고 하며, LDA는 이 토픽 모델링을 수행하는 주된 방법 중 하나입니다.
θ_d (문서–토픽 분포)
문서 d 안에 어떤 토픽들이 얼마나 섞여 있는지를 나타내는 비율
예: 문서 A는 정치 70퍼센트, 경제 20퍼센트, 스포츠 10퍼센트 이런 식
ϕ_k (토픽–단어 분포)
토픽 k 안에서 어떤 단어들이 얼마나 자주 등장하는지를 나타내는 확률
예: ‘스포츠’ 토픽에서는 “선수”, “경기”, “팀” 같은 단어가 높은 확률
z_dn (단어의 토픽 라벨)
문서 d의 n번째 단어가 어떤 토픽에서 나왔다고 판단되는지
예: 문서 내 한 단어가 ‘정치’, 다른 단어는 ‘경제’ 등으로 라벨링됨
LDA 학습 방식의 핵심 흐름
z_dn을 알고 있다면 θ_d와 ϕ_k를 쉽게 계산할 수 있음
하지만 실제로는 z_dn(각 단어의 토픽 라벨)을 모르기 때문에 이를 샘플링하거나 최적화 방식으로 추정함
z_dn을 하나씩 추정할 때마다 θ_d와 ϕ_k를 다시 계산하고 갱신
이 과정을 문서 전체에 반복하면서 모델이 점점 안정된 토픽 구조를 찾아감
정리하면
LDA는 문서에 숨겨진 토픽 구조를 찾아내기 위해
단어의 토픽 라벨 z를 계속 추정하고
그에 따라 문서–토픽 분포 θ와 토픽–단어 분포 ϕ를 반복적으로 업데이트하는 과정이라 보면 됨
LDA는 확률적 생성 모델
1. 확률적 생성 모델이란?
- LDA는 **데이터(문서와 단어)**가 어떤 확률적인 원리에 의해 만들어졌다고 가정하는 모델입니다.
- 이 가정한 원리(생성 과정)를 **수학적(확률 분포)**으로 표현하고 적어 놓은 것입니다.
- 우리가 관찰한 결과(문서)를 가장 잘 설명하는 숨겨진 확률 분포를 역으로 찾아내는 것이 목표입니다.
2. 생성 과정: 토픽-단어 분포 생성 단계
LDA가 문서를 생성한다고 가정할 때, 가장 먼저 일어나는 일은 ‘토픽’과 ‘단어’ 간의 관계를 정의하는 것입니다.
- 1단계: 토픽 개수 K 결정
- 문서 집합에서 몇 개의 토픽이 존재할지 미리 결정합니다.
- 예시에서는 K = 3으로, ‘배송’, ‘가격’, ‘품질’이라는 세 가지 토픽을 가정했습니다.
- 2단계: 토픽별 단어 분포 추정 (생성)
- 결정된 각 토픽 K에 대해, 해당 토픽이 어떤 단어를 얼마나 높은 확률로 포함할지(좋아할지)를 결정합니다.
- 예를 들어, 토픽 ‘배송’은 ‘빠르다’, ‘도착’ 같은 단어에 높은 확률을 부여합니다.
- 결과: 토픽-단어 테이블 가정
- 이 단계를 거치면 다음과 같은 토픽-단어 테이블이 만들어졌다고 가정합니다.
- 토픽 1: “배송/빠르다/어제/도착” (이 단어들이 토픽 1에서 나올 확률이 높음)
- 토픽 2: “가격/저렴/비싸다/할인”
- 토픽 3: “품질/재질/튼튼하다/마감”
- 이 단계를 거치면 다음과 같은 토픽-단어 테이블이 만들어졌다고 가정합니다.
문서 생성 단계란?
LDA가 가정하는 “문서가 만들어지는 방식”이며, 실제 학습 과정도 이 가정을 거꾸로 추적하는 형태로 이루어짐.
1단계: 문서 전체의 토픽 비율(θ_d)을 먼저 정함
문서 하나가 어떤 토픽들로 구성되어 있는지 비율을 지정
예: θ_d = [0.7, 0.2, 0.1]
배송 관련 내용이 70퍼센트
가격 관련 내용이 20퍼센트
품질 관련 내용이 10퍼센트
이 문서는 이런 토픽 조합으로 구성된다고 가정하는 것
2단계: 문서 안의 각 단어가 어떤 토픽에서 왔는지를 결정(z_dn 선택)
문서 D1이 단어 5개를 가진 상황을 예로 들면
각 단어 위치 n마다 θ_d를 보고 토픽을 하나 뽑는다
단어 1번 위치
θ_d가 [0.9, 0.1]이라면
90퍼센트 확률로 토픽1
10퍼센트 확률로 토픽2
→ 예: z_11 = 토픽1
단어 2번 위치
다시 θ_d를 참조해서 토픽을 하나 뽑음
→ 예: z_12 = 토픽1
단어 3번 위치
→ 예: z_13 = 토픽1
단어 4번, 5번도 같은 방식으로 토픽을 무작위 선택
3단계: 선택된 토픽(z_dn)에서 실제 단어(w_dn)를 뽑는 과정
앞 단계에서 각 단어 위치마다 “이 단어는 어떤 토픽에서 왔다”라는 토픽 라벨 z_dn이 정해졌다면
이제 그 토픽의 단어 분포(ϕ_k)에서 실제 단어를 하나 샘플링한다.
예시
z_11이 토픽1이라면
토픽1의 단어 분포에서 단어를 하나 뽑음
경기, 선수, 득점, 팀 같은 단어가 등장할 확률이 높음
z_14가 토픽2라면
토픽2의 단어 분포에서 단어를 하나 뽑음
주식, 주가, 시장, 상승 같은 단어가 나올 가능성이 큼
이 과정을 문서의 모든 단어 위치에 반복하면
문서 D1은
“경기 선수 득점 주가 팀”
처럼 각 토픽에서 나온 단어들이 조합된 하나의 문서가 만들어짐
정리
1단계: 문서 전체의 토픽 비율 생성
2단계: 각 단어가 어떤 토픽에서 왔는지 선택
3단계: 선택된 토픽의 단어 분포에서 실제 단어를 샘플링
이 3단계를 통해 문서가 생성된다고 LDA는 가정하며
학습 시에는 이 과정을 거꾸로 추정해서 토픽을 찾아냄.
다시 정리
LDA가 가정하는 문서 생성 과정
문서가 만들어지는 과정을 ‘확률적 생성 모델’로 상상한 뒤
그 과정을 역추적하는 방식으로 토픽을 추정함.
1단계
문서마다 토픽 비율 θ_d를 하나 샘플링
예: [0.7, 0.2, 0.1]
2단계
문서 안의 각 단어 위치 n에 대해
θ_d를 보고 해당 단어의 토픽 z_dn을 선택
예: 대부분이 토픽1로 선택될 수 있음
3단계
선택된 토픽 z_dn의 단어 분포 ϕ_k에서
실제 단어 w_dn을 하나 샘플링
예: 토픽1이라면 “경기, 선수, 득점” 같은 단어가 나올 확률이 높음
이 과정을 단어 수만큼 반복하면 문서 하나가 생성된다고 가정함.
? 학습(Training)은 이 과정을 ‘거꾸로’ 하는 것
실제 문서에는 단어들만 있음
토픽 비율(θ), 단어의 토픽 라벨(z), 토픽 단어 분포(ϕ)는 모두 숨겨져 있음
그래서 LDA는 다음 과정을 반복함
단어의 토픽 라벨 z 추정
→ 그에 맞춰 θ와 ϕ 갱신
→ 다시 z 추정
→ 반복하면서 토픽 구조가 점점 안정됨
즉,
단어들이 어떤 토픽에서 왔는지(z)
각 문서의 토픽 비율이 무엇인지(θ)
각 토픽이 어떤 단어로 구성되는지(ϕ)
이 세 가지를 함께 찾아가는 과정이 LDA 학습의 본질.
? LDA를 통해 얻을 수 있는 결과
문서별 토픽 비율
예: 문서 A는 “정치 60퍼센트, 경제 40퍼센트”
토픽별 대표 단어
토픽1: 경기, 선수, 득점
토픽2: 주식, 시장, 상승
문서의 주제 구조를 명확히 파악할 수 있어
리뷰 분석, 뉴스 클러스터링, 추천 시스템 등에서 널리 사용됨.
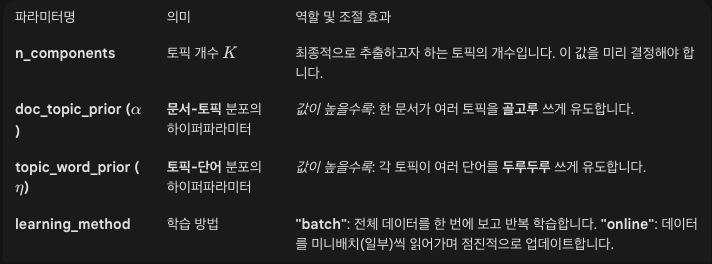
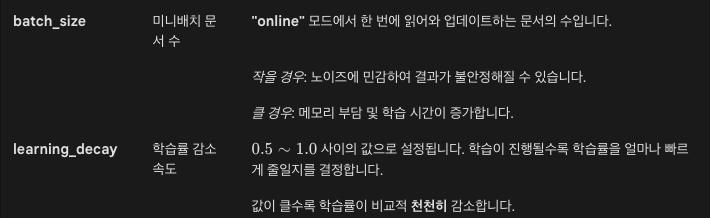
lda = LatentDirichletAllocation(
    n_components=5,
    doc_topic_prior=None, # None이면 1 / n_components 로 자동 설정
    topic_word_prior=None, # None이면 1 / n_components 로 자동 설정
    learning_method="batch“, # 또는 "online“
)
import numpy as np # 배열 및 수학 연산을 위한 라이브러리 (결과 출력에 사용)
from sklearn.feature_extraction.text import CountVectorizer # 텍스트를 단어 빈도 벡터로 변환하는 클래스
from sklearn.decomposition import LatentDirichletAllocation # LDA 모델을 구현한 클래스

# 분석할 문서(doc) 리스트. LDA의 입력 데이터가 됩니다.
docs = [
    "배송이 빠르고 포장이 깔끔해서 좋았어요",
    "배송이 느리고 박스가 찢어져 와서 별로였어요",
    # .... (여기에 더 많은 문서가 있다고 가정합니다.)
]

# --- 1. 단어 카운트 벡터화 (피처 추출) ---

# CountVectorizer 객체 생성. 텍스트를 단어 빈도 기반의 행렬로 변환합니다.
vectorizer = CountVectorizer()

# fit_transform을 통해 다음 두 가지 작업을 동시에 수행합니다.
# 1. fit: docs를 분석하여 단어장(Vocabulary)을 구축합니다. (어떤 단어가 있는지 파악)
# 2. transform: docs를 단어장 기반의 빈도 행렬(문서-단어 행렬)로 변환합니다.
# X는 희소 행렬(Sparse Matrix) 형태로 저장됩니다.
X = vectorizer.fit_transform(docs)

# 문서-단어 행렬의 크기를 출력합니다.
# (문서 수, 단어 수). LDA 모델의 입력 차원입니다.
print("문서-단어 행렬 크기:", X.shape)

# --- 2. LDA 모델 설정 및 학습 ---

n_topics = 3 # 추출하고자 하는 토픽의 개수 K를 설정합니다.

# LatentDirichletAllocation 객체 생성
lda = LatentDirichletAllocation(
    n_components=n_topics,    # 추출할 토픽 개수 K를 지정합니다.
    learning_method="batch",  # 학습 방법 지정: 'batch'는 전체 데이터를 한 번에 보고 학습합니다.
    random_state=42           # 재현성을 위한 난수 시드 설정
)

# 학습 (fit) 및 변환 (transform)을 동시에 수행합니다.
# fit: X를 이용해 토픽-단어 분포 (phi: lda.components_)를 추정합니다.
# transform: 학습된 phi를 이용해 X를 문서-토픽 분포 (theta: doc_topic)로 변환합니다.
# doc_topic은 각 문서별 토픽 비중이 저장된 행렬입니다.
doc_topic = lda.fit_transform(X) # shape: (n_docs, n_topics)

# (참고용 주석)
# print(doc_topic.sum(axis=1)) # 각 행(문서)의 합은 1에 가까워야 합니다.
# print(lda.components_) # 토픽-단어 분포 행렬 (phi)

# --- 3. 결과 분석 및 출력 ---

# 토픽별 상위 단어를 출력하는 함수를 정의합니다.
# model.components_는 토픽-단어 분포 (phi)를 나타냅니다.
# 이는 토픽 k에서 단어 w가 나타날 확률을 나타냅니다.
def print_topics(model, feature_names, n_top_words=5):
    # model.components_는 (n_topics, n_features) 크기의 행렬입니다.
    # 각 행은 하나의 토픽을, 각 열은 단어(feature)를 나타냅니다.
    for topic_idx, topic in enumerate(model.components_):

        # topic: 각 단어별 "카운트 비슷한 값" (클수록 그 토픽에서 더 중요한 단어)
        # 1. topic.argsort(): 토픽에 대한 단어들의 중요도를 오름차순으로 정렬한 인덱스 배열을 반환합니다.
        # 2. [::-1]: 인덱스 배열을 내림차순으로 뒤집습니다. (가장 중요한 단어가 앞으로 옴)
        # 3. [:n_top_words]: 앞에서부터 n_top_words 개만 선택합니다.
        top_indices = topic.argsort()[::-1][:n_top_words]

        # 선택된 인덱스를 이용해 실제 단어(feature_names)를 추출합니다.
        top_words = [feature_names[i] for i in top_indices]

        # 토픽 번호와 상위 단어를 출력합니다.
        print(f"Topic {topic_idx}: {', '.join(top_words)}")

# CountVectorizer가 학습한 단어장(feature) 이름을 가져옵니다.
feature_names = vectorizer.get_feature_names_out()

# 정의한 함수를 호출하여 토픽별 상위 5개 단어를 출력합니다.
print_topics(lda, feature_names, n_top_words=5)

# 문서별 토픽 비중(theta: doc_topic)을 확인합니다.
for i, topic_dist in enumerate(doc_topic):
    # 각 문서가 3개의 토픽에 대해 어떤 비율로 구성되어 있는지 출력합니다.
    # np.round를 사용하여 소수점 셋째 자리까지 반올림하여 출력합니다.
    print(f"문서 {i} 토픽 분포:", np.round(topic_dist, 3))