결정 트리(Decision Tree)
분류(Classification)와 회귀(Regression) 모두 가능한 지도 학습 모델 중 하나
스무고개 하듯이 예/아니오 질문을 이어가며 학습
가지 분리 기준
• 데이터를 섞여 있지 않게, 가장 깔끔하게 나누는 질문
• 불순도가 낮아지고 순수도가 높아지는 방향으로 분리
• 불확실성이 낮아지는 방향
• 최종 노드가 너무 많으면 Overfitting 가능성이 커짐
불순도 측정 지표
• 값이 작을수록 순수도가 높음(분류가 잘 됨): 0~1
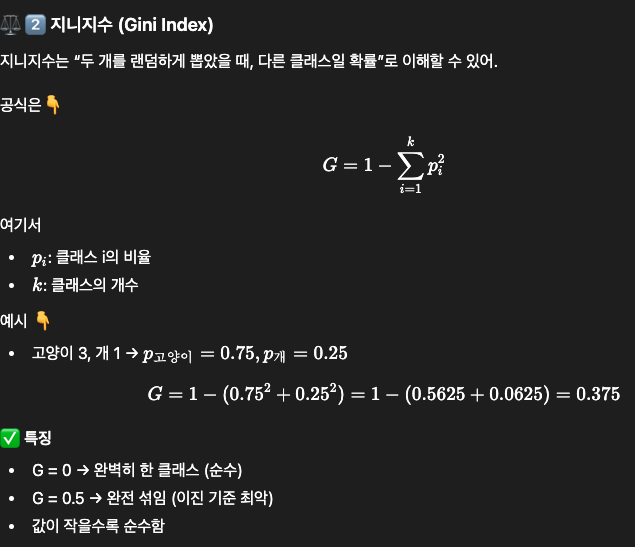
• 지니(Gini)지수
1 − Σkᵢ₌₁pᵢ² => 1 − Σ(각 범주별 개수/전체개수)²
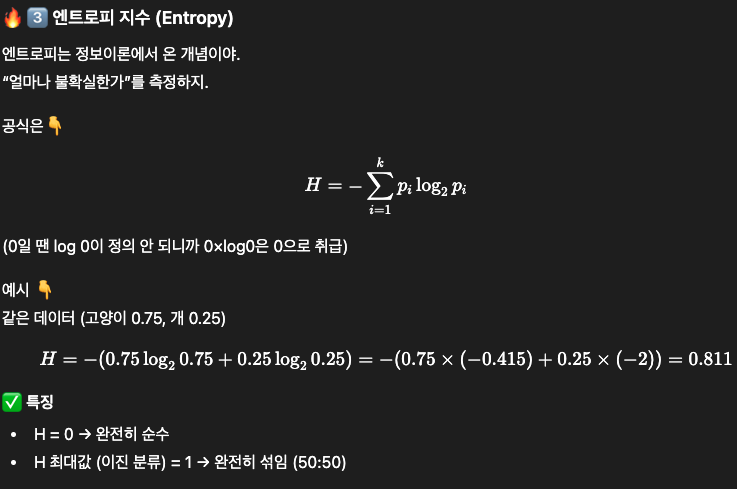
• 엔트로피(Entropy)지수
− Σkᵢ₌₁pᵢ log₂pᵢ
정보 이득 (Information gain)
• 부모 노드와 자식 노드간의 불순도 차이
가지치기 규칙 (Pruning rule)
• 오버피팅(과적합)을 막기 위한 전략
• 트리의 최대 깊이나 터미널 노드의 최대 개수, 혹은 한 노드가 분할하기 위한 최소 데이터 수를 제한하는 것
• 하이퍼 파라미터 지정으로 제한
- min_sample_split : 부모 노드를 쪼개기 위해 필요한 최소 샘플 수
- max_depth : 트리의 최대 깊이 지정
- min_samples_leaf : 리프노드(터미널 노드)의 최소 샘플수 지정
- max_features : 노드 분할 시 고려할 특성(피처) 수의 상한
max_features의 값

None          전체 특성 다 사용            feature   10개면 10개 전부 사용
"sqrt"        전체 특성 수의 제곱근만 사용    feature 100개면 → 10개만 무작위 선택
"log2"        전체 특성 수의 로그2값만 사용   feature 100개면 → 약 7개만 선택
정수 (int)     지정한 개수만 사용            5면 무조건 5개
실수 (float)   비율로 지정                 0.5면 절반만 선택
예시
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier, plot_tree
from sklearn.metrics import accuracy_score, classification_report
import matplotlib.pyplot as plt

iris = load_iris(as_frame=True)
X = iris.data
Y = iris.target

x_train, x_test, y_train, y_test = train_test_split(
    X, Y, test_size=0.2, random_state=42, stratify=Y
)

dt = DecisionTreeClassifier(max_depth=5, random_state=42)
dt.fit(x_train, y_train)

pred = dt.predict(x_test)
print(accuracy_score(y_test, pred))
print(classification_report(y_test, pred))

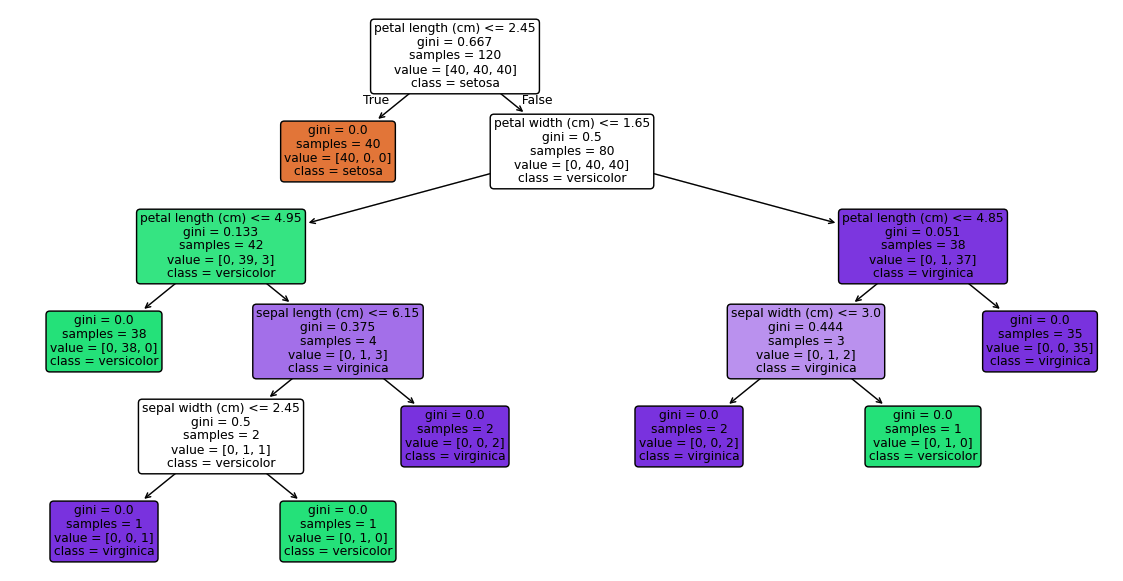
plt.figure(figsize=(12, 6))
plot_tree(
    dt,
    feature_names=X.columns,
    class_names=iris.target_names,
    filled=True,
    rounded=True,
)
plt.tight_layout()
plt.show()

print(dt.feature_importances_)

for name, imp in zip(X.columns, dt.feature_importances_):
    print(f"{name:20s} {imp:.3f}")
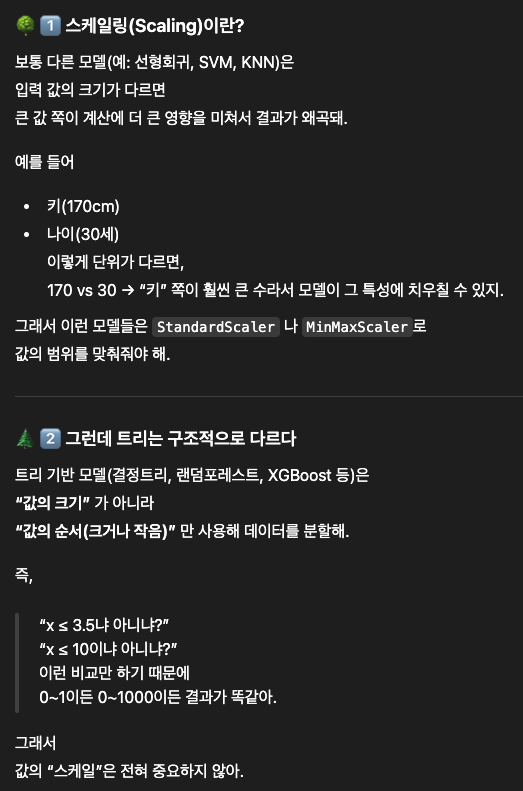
트리는 스케일링을 할 필요가 없음